Evaluación
- TAREAS: Actividades en grupo sesiones V5
- LABORATORIOS: trabajo autonomo de programacion
NT = prom(PEP1, PEP2, (7 Tareas * 0,7 + 1 Proyecto * 0,3))
NF = NT*0,7 + NL*0,3
NL = prom(L1, L2, L3)
Under the cover: Intro a RISC-V
RISC-V es una ISA (Instruction Set Architecture) de Instrucciones Reducidas. Durante el curso nos centraremos en RISC-V RV321 Base 32 Bits. Cada instrucción aritmética en RISC-V tiene exactamente 3 variables.
Registros
Un registro es una primitiva usada en el diseño del hardware. RISC-V utiliza 32 registros indexados desde x0-x31. Cada uno es a su vez, de 32 bits (o 4 bytes, o una word). Los registros se utilizan como operandos en las instrucciones aritméticas de RISC-V.
Cada registro posee una convención que indica su propósito.
Instrucciones
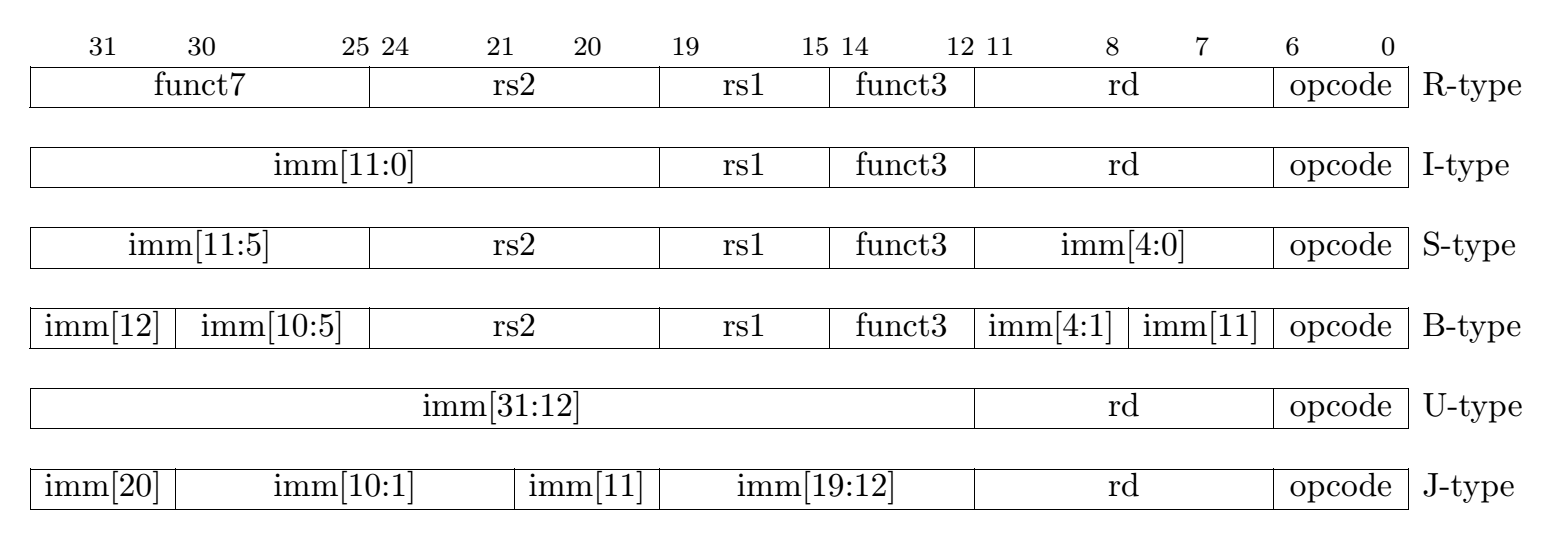
RISC-V utiliza un conjunto de instrucciones catalogadas por tipos según la función que cumplen. Cada tipo comparte una manera de distribuir estos 32 bits segun los requisitos de la instruccion.
Tipo R (Register)
Usado para operaciones registro-registro. (add, sub, xor). Esencialmente, utiliza rs1 y rs2 para escribir en rd.
funct7 y funct3 funcionan como opcodes adicionales, y los registros son siempre de 5 bits. Por ejemplo, el opcode 51 está asociado a add, pero con su funct7 = 32, está asociado a sub.
Tipo I (Immediate)
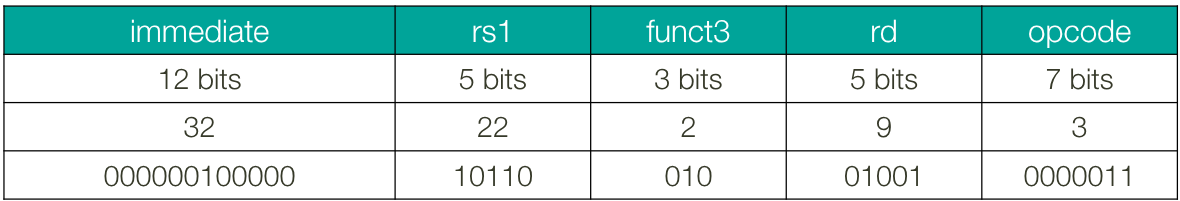
Usado para operaciones registro-inmediato. (addi, lw, lb). Usa rs1, rd y un inmediato.
Por ejemplo, la instrucción lw x9, 32(x22) se representa como:
Tipo S (Store)
Usado para operaciones registro-memoria que guardan datos de los registros en la memoria. (sw, sb). Usa rs1, rs2 y un inmediato para identificar la direccion de memoria
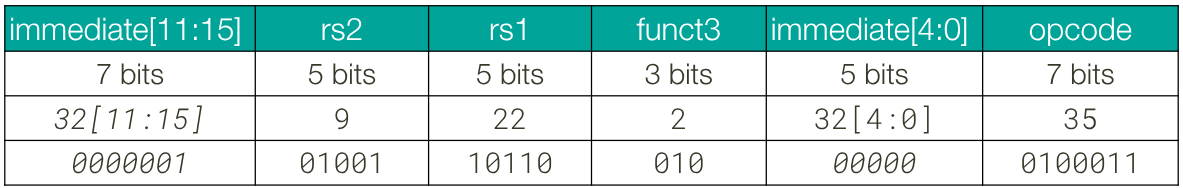
sw x9, 32(x22)
En este caso, el campo immediate, que tiene siempre 12 bits, se divide en dos rangos. immediate [11:5] y immediate [4:0] forman, al unirse, el numero 32, en 12 bits. Sin embargo, el inmediato esta segmentado en nombre de la consistencia, rs2 siempre busca ocupar los mismos 5 bits, y ya que el inmediato completo utiliza el lugar de rs2, se separan esos 5 bits, y aparece immediate[4:0]. En esencia, aunque separados, los inmediatos guardan el offset.
Tipo B (Branch), tambien llamado SB
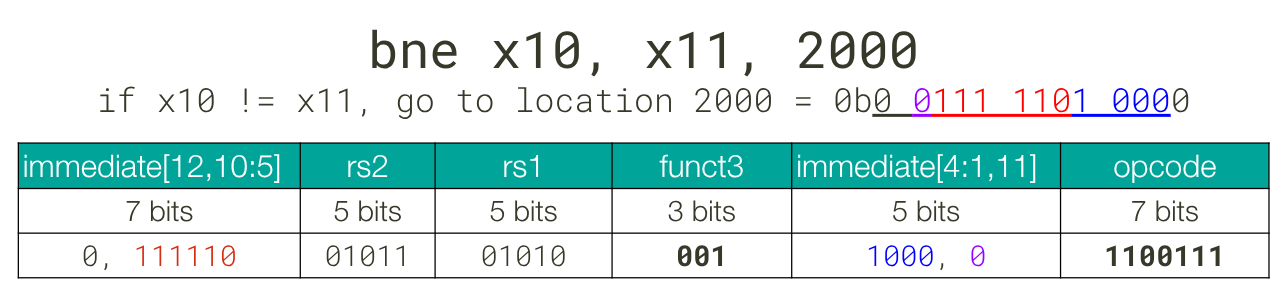
Usado para branching condicional (beq, bne). Es similar a S, usa rs1, rs2 para la condicion y un inmediato para la direccion del branch.
Tipo U (Upper Immediate)
Usado para cargar constantes grandes. Usa un inmediato de 20 bits.
Tipo J / UJ (Jump)
Usado para saltos incondicionales. Usa un inmediato de 20 bits con objetivo en rd.
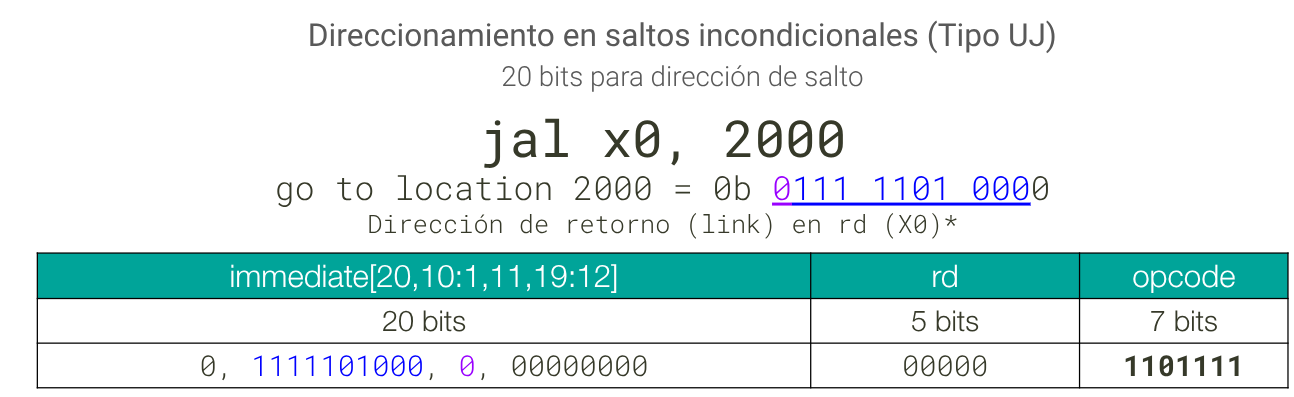
Es evidente que ambas formas de branching tienen alcances distintos, ya que el inmediato que indica duantos bits deben moverse tiene distintas limitaciones de tamaño. Así, los saltos SB tienen un alcance de 4KiB, mientras que los saltos UJ tienen un alcance de 1MiB.
Sin embargo, la mayoria de programas son mas grandes que eso, asi que el alcance se mejora de dos formas:
-
Direccionamiento relativo al Program Counter. Así, podemos realizar saltos con ese mismo alcance, pero relativos a una posicion en el programa (PC + (2000 bytes))
-
Direcciones como halfwords en vez de bytes. En la arquitectura de RISC, las instrucciones siempre miden 32 bits (4 bytes, 1 word) o 16 bits (2 bytes, 1 halfword). Por ende, no es posible que una instruccion empiece en una direccion impar.
Asi, el ultimo bit binario de una direccion, siempre va a ser 0, ya que las direcciones a las que queremos llegar (las que guardan el inicio de una instruccion) siempre son pares, por lo que no tiene sentido saltar una cantidad impar de bytes.
Así, para que ese ultimo bit que esta permanentemente en 0 no se desperdicie, cambiamos la convencion de salto: no saltamos de byte en byte sino de halfword en halfword, esencialmente “duplicando” el alcance, podemos insertar como salto un numero de hasta 12 bits, y ya que estamos saltando de 2 en 2, el alcance efectivo es de 13 bits.
El efecto observable es simplemente que si ingresamos un inmediato de 256, estaremos avanzando 256 halfwords, lo que es decir, 512 bytes.
Procedimientos
Stack Pointer
Procesador RISC-V Monociclo
Datapath
Al entender la estructura de la instrucción en binario que representa cada tipo de orden, nace la siguiente pregunta: cómo interpreta el procesador la instrucción para hacer que las cosas ocurran?.
La respuesta es, fundamentalmente, a través de un circuito, que pueda utilizar la “señal” representada por los 32 bits de la instrucción, y operarla a través del diseño de un procesador monociclo para generar el resultado esperado.
Es de esperarse que un procesador monociclo de 32 bits sea un circuito altamente abstraído para el objeto de nuestro estudio. Más adelante, veremos crudamente como opera cada uno de sus módulos, especialmente sus señales de control.
Ciclo de Instrucción
La primera noción que debemos construir, es que el procesador interpreta la señal en “fases”[^1].

Así es como se divide crudamente el Datapath del procesador monociclo. Podemos trazar el camino de datos de cualquier instrucción observando un esquema del procesador monociclo
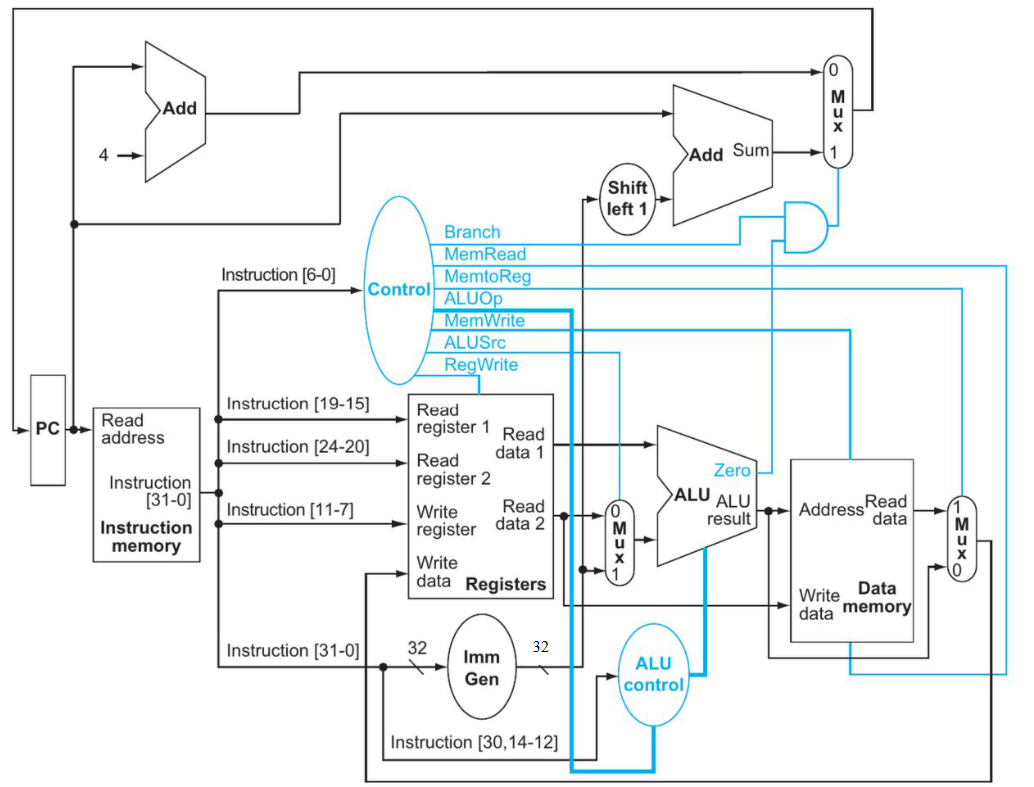
IF [Instruction Fetch]
“Fetchea”, o va a buscar, la instrucción a la que apunta el Program Counter. Esencialmente, en este fase se va a buscar la señal que vamos a interpretar
ID [Instruction Decode]
En esta fase, la unidad de control interpreta la instruccion fetcheada, la “divide en partes”, y prepara las señales de control que va a requerir la instrucción. En esta fase, suceden una multitud de cosas, que podemos ver evidenciadas de las 5 flechas que salen de la fase inicial.
Haremos el ejercicio de revisar, de abajo hacia arriba (que para el formato de instrucción es análogo de izquierda a derecha), a donde va cada fragmento de la instrucción, relacionándolo con los formatos de instrucción que vimos anteriormente.
Debemos darnos cuenta de que la noción de “separar” la señal a nuestra conveniencia no implica, literalmente “separar” los bits. Si esto fuera así, sería imposible enviar Instruction[31-0], ya que se estaria “llevando” toda la instruccion. Estamos hablando de señales eléctricas, los módulos “escuchan” la parte que les interesa de la instrucción, pero no estamos literalmente separándola.
- Instruction[31-0]
CONVERSIONES: Binario, Decimal y Hexadecimal
Decimal - binario
- Dividir el numero en dos
- Guarda la parte entera de la division
- El resto de la division es el digito binario
- Repite hasta que el cuociente sea 0
- Abajo hacia arriba == Izquierda a derecha
Luego, de binario a hexadecimal, entendemos que es una tabla de potencias de 2 ordenada de derecha a izquierda, donde el hecho de que un numero sea 0 o 1 indica si debe “activarse” o no. Además, para un numero binario de n bits, puedes representar numeros. Con 4 bits puedes representar 16 numeros, por ejemplo.
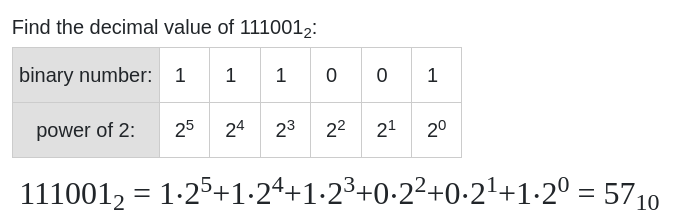
Decimal - Hexadecimal
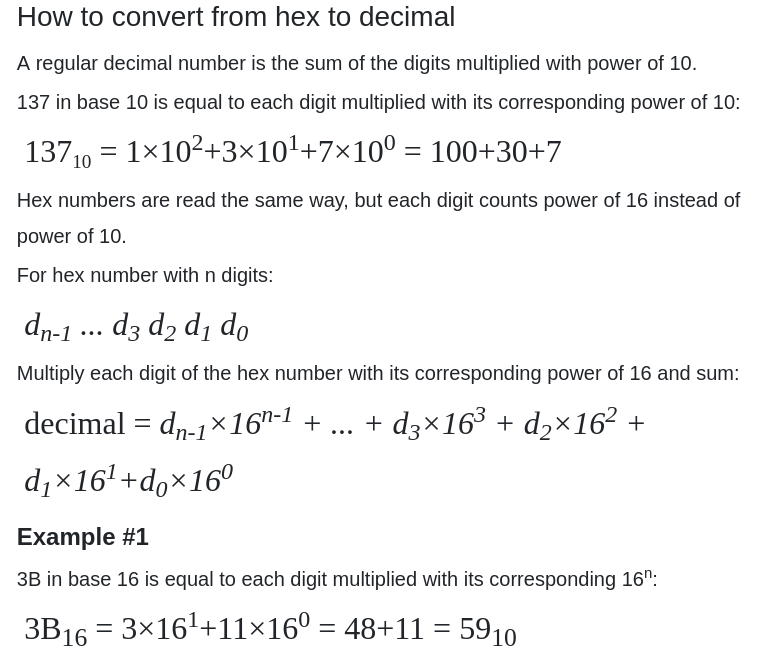
Los numeros hexadecimales son numeros expresados en base 16:
0,1,2,3,4,5,6,7,8,9,A,B,C,D,E,F
Decimal a Hexadecimal
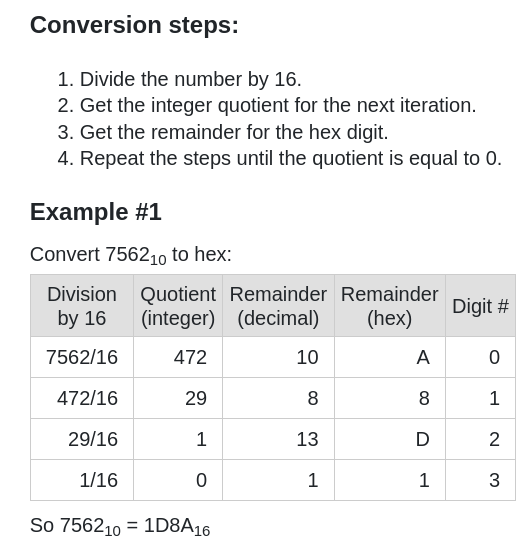
Hexadecimal - Decimal
Pipeline
Entendemos por pipeline, o tecnica de pipelining, a un metodo alternativo de flujo para el procesador monociclo que ya conocemos.
Hasta ahora, hemos utilizado el procesador con un CPI de una instruccion por ciclo, es decir, que cada instruccion pasa “sola” por las 5 fases: IF, ID, EX, MEM y WB. Sin embargo, la tecnica de pipeline es una tecnica de mejora de rendimiento bastante astuta; mejora el desempeño del procesador aumentando el throughput en vez de mejorando el tiempo de ejecucion de alguna instruccion en particular.
Es decir, no tenemos un procesador mas “rapido”, sino que segmentamos el uso de las 5 fases del procesador en pipelines; ya que cada fase es lo suficientemente distinguida de la otra, 5 instrucciones pueden procesarse a la vez utilizando una fase del procesador cada una.
|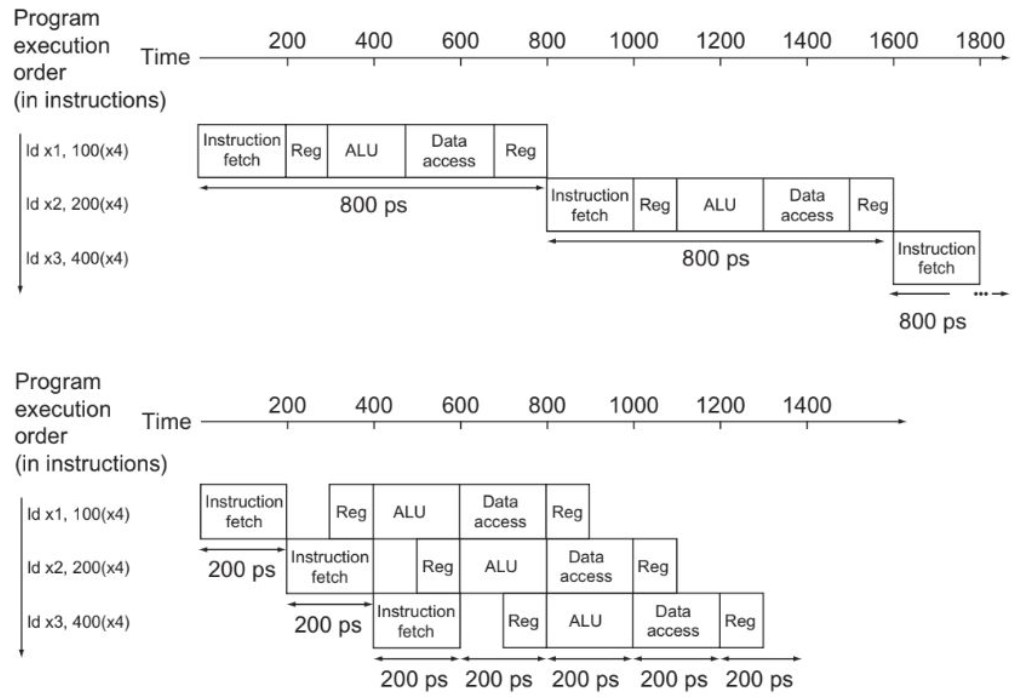
Esencialmente estamos “solapando” la ejecucion de 5 instrucciones a la vez; teoricamente, cuando hemos engageado todas las fases del pipeline, estamos trabajando con x5 veces el throughput del procesador monociclo.
Sin embargo, como la imagen lo evidencia, debemos redefinir nuestro ciclo de reloj. El nuevo tiempo de ejecucion de un ciclo de reloj es aquel de la fase mas larga del procesador.
Hazards
Por supuesto, no es posible que tal mejora de rendimiento no traiga ciertos riesgos. Existen 3 tipos de riesgos que debemos avertir al trabajar con un procesador con Pipeline.
- Estructurales: Un recurso requerido esta en uso
- Por ejemplo, en RISC-V con pipeline y una unica memoria, Load/Store requieren acceso a datos, e IF tendria que esperar ese ciclo. Un datapath con pipeline REQUIERE una memoria caché separada.
- Datos: Se requiere esperar a que otra instruccion previa complete escritura/lectura de datos, antes de volver a referenciarlo.
- Control: Decidir sobre una accion de control requiere una instruccion previa.
Riesgos de datos
Un riesgo de datos ocurre cuando una instruccion intenta referenciar un dato que sera actualizado por la instruccion anterior, pero aun no llega a la fase donde su valor sera realmente actualizado en el registro. Por ejemplo:
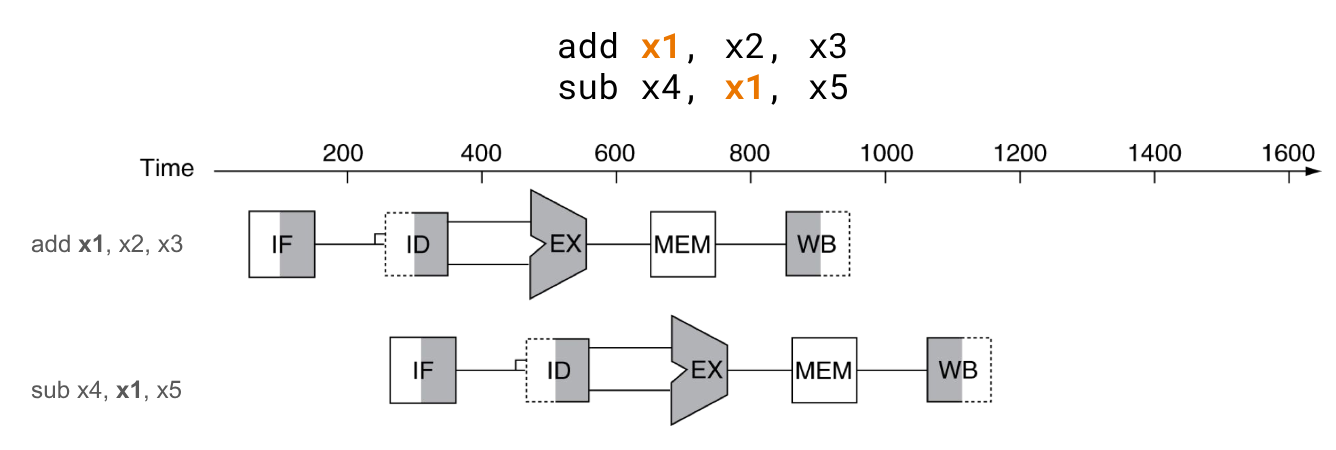
Aqui, gracias a la primera instruccion, x1 será actualizado en WB, en 800ps de ejecucion. Sin embargo, la siguiente instruccion necesita el valor actualizado de x1 en su fase ID, es decir, 400ps antes.
La solucion inmediata es simple; hacer que la segunda instruccion espere a que la primera llegue a actualizar x1.
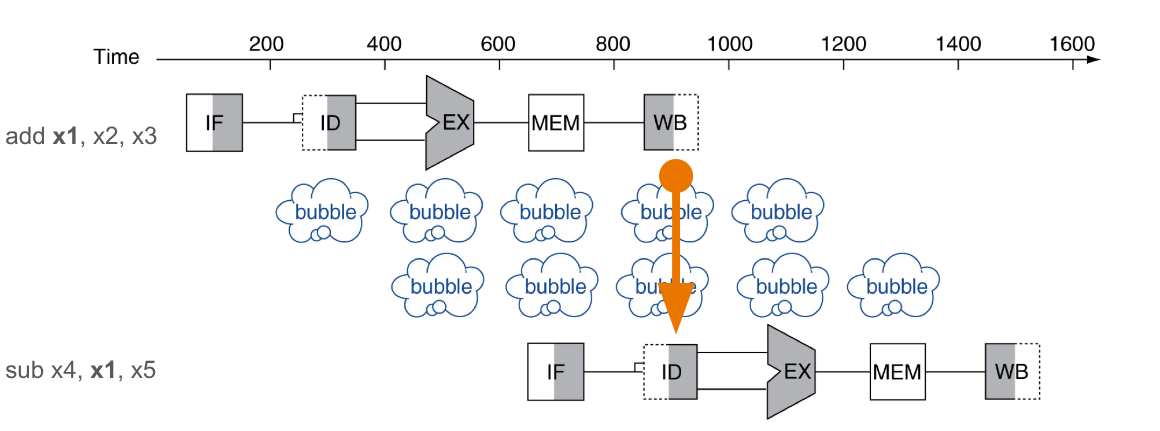
Llamamos a estos “desfases” de ciclos NOPs, y nos ayudan a alinear correctamente las fases del procesador.
Sin embargo, esto es evidentemente al costo de rendimiento que implique perder esos dos ciclos necesarios para avertir el riesgo de dato.
Forwarding
Asi, una manera de evitar el riesgo de dato es a través del forwarding. En el esquema de “circuito” del procesador, el forwarding aparece como nuevas conexiones y nuevas señales que deben conectar las distintas fases del procesador. Sin embargo, esquemáticamente podemos entender el forwarding así.
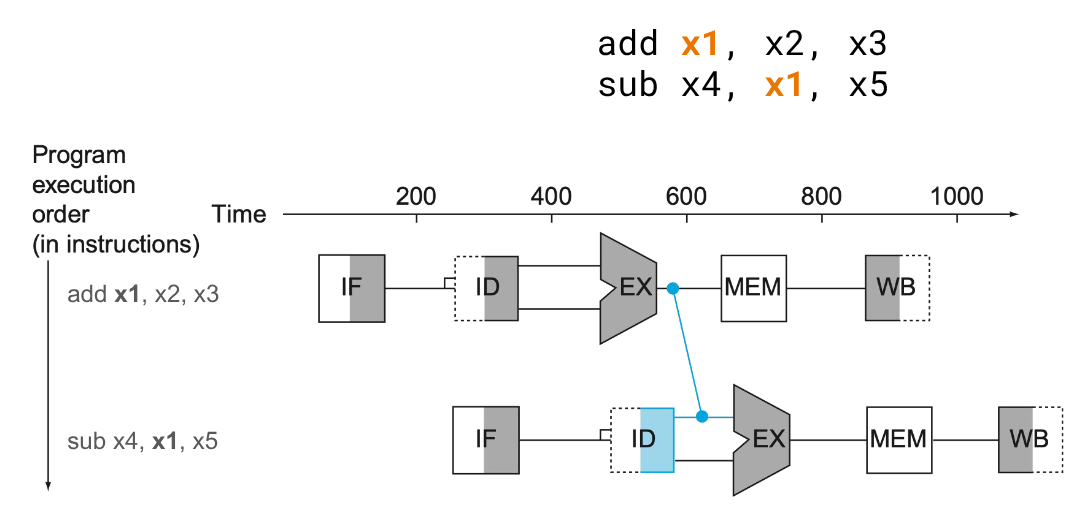
En este caso, sub necesita el resultado que se va a guardar en x1 en la fase ID. Afortunadamente, aunque este resultado aun no se ha guardado en x1, su valor ya ha sido calculado, por lo que podemos conectar la fase EX con la fase ID para “pasarle anticipadamente” el valor cuando lo necesita.
El forwarding reduce considerablemente la necesidad de NOPs, saldando asi ese riesgo de performance. Sin embargo, no es estrictamente una solucion general.
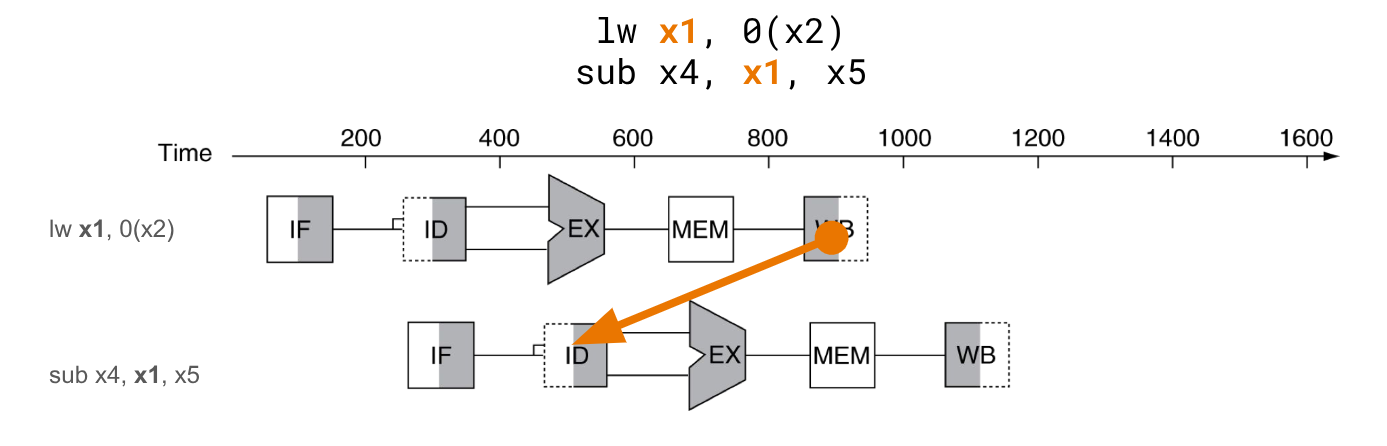 En este clase de riesgo de dato, la primera instrucción está intentando cargar en
x1 el valor dentro de la direccion 0(x2). Sin embargo, este valor solo esta disponible tras la fase MEM de la primera instruccion. Esto no puede solucionarse solo con forwarding, no hay forma de tener el dato aun más anticipadamente.
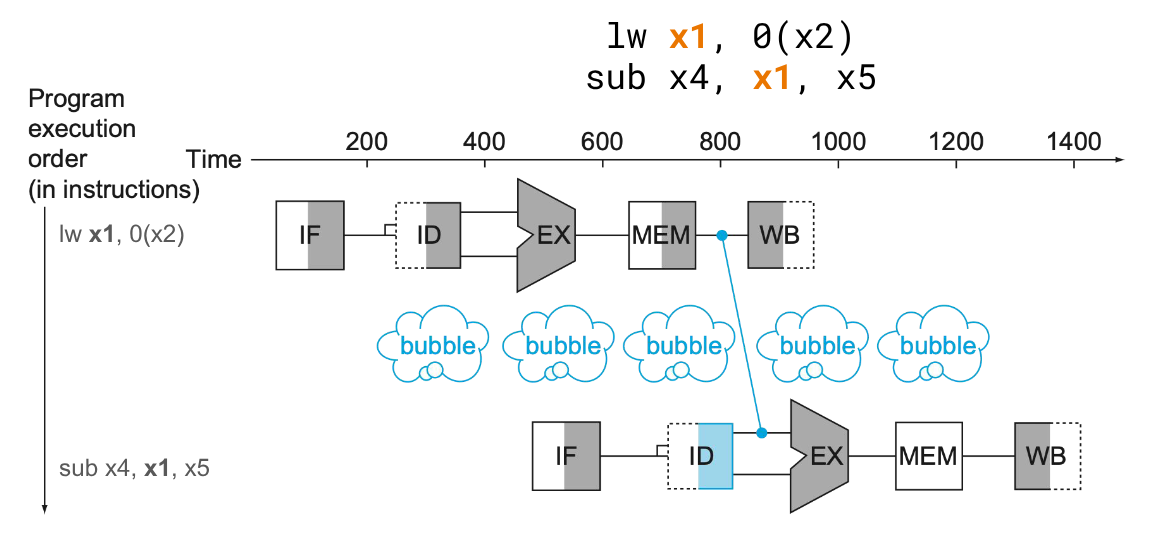 En este caso, forwardeamos el dato desde MEM hasta ID, añadiendo un NOP entre medio que nos permitiera alinear estas fases. No es libre de NOP, pero sin forwarding, esto hubiera tomado tres NOP.
Los NOPs, o stalls, se pueden evitar ocasionalmente con solo un reordenamiento del codigo mas conveniente para el camino de datos del pipeline.
Riesgos en saltos condicionales
Rendimiento de Memoria Cache
En terminos de rendimiento de memoria caché aplicamos algunas fórmulas conocidas previamente.
\\ \large \text{2) } \text{Ciclos espera Memoria}= \text{Ciclos espera Read + Ciclos espera Write} \\ \end{align}$$ $$\large \text{3) } \text{Ciclos espera Read}= \text{(Lecturas/Programa) * Read Miss Rate * Read Miss Penalty}$$ $$\large \text{4) } \text{Ciclos espera Write}= \text{(Escrituras/Programa) * Write Miss Rate * Write Miss Penalty + Esperas Buffer Escritura}$$ En una arquitectura **write-trough**, con buffer de escritura, en general lectura y escritura tienen de buffer, los ciclos de espera de memoria pueden ser derechamente: $$\large \text{2.1) } \text{Ciclos espera Memoria}= \text{Accesos/Programa * Miss Rate * Miss Penalty}$$ $$\large \text{2.2) } \text{Ciclos espera Memoria}= \text{Instrucciones/Programa * Desaciertos/Instruccion * Miss Penalty}$$ Podemos tambien calcular el **Tiempo Promedio de Acceso a la Memoria (AMAT):** $$\large AMAT = \text{Tiempo de Acierto [s] + Miss Rate * Miss Penalty}$$ [^1]: La noción de "fases" es bastante más imaginaria y flexible de lo que puede parece en esta parte del curso, pero por ahora representa un esquema suficiente